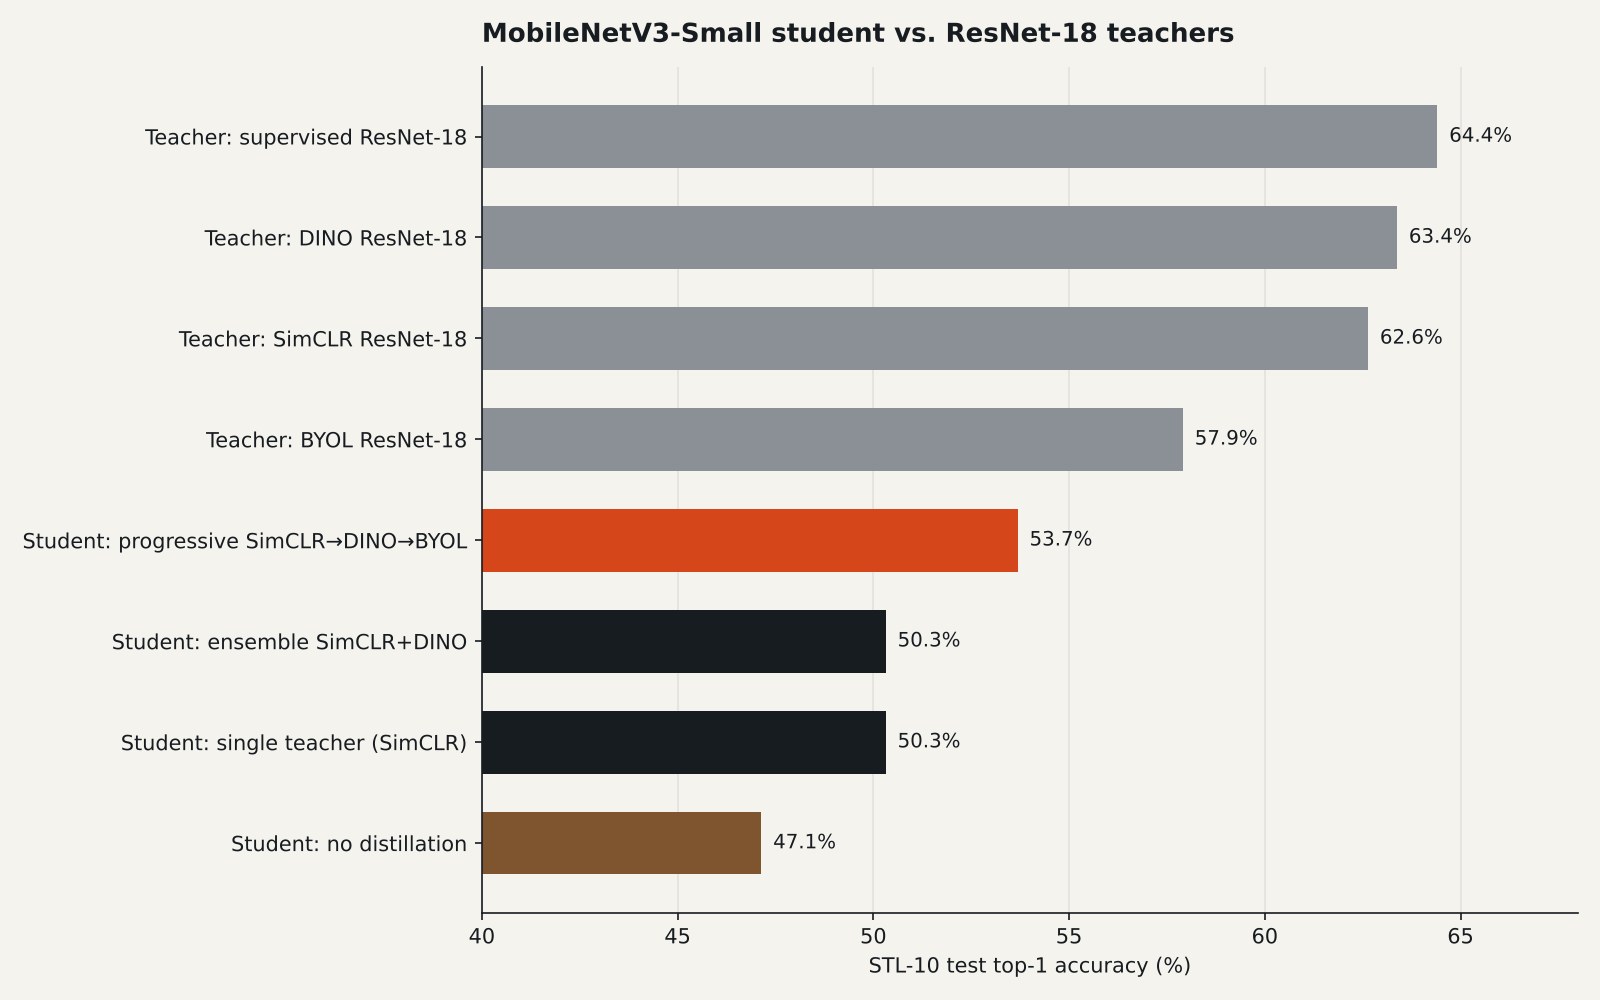
هل يستطيع نموذج صغير أن يتعلم من معلّمين كبار مدرَّبين بالتعلم الذاتي الإشراف (self-supervised learning)، باستخدام عدد قليل من العناوين (labels) فقط؟
مشروع مقرر دراسي لمقرر CHE 567 (الذكاء الاصطناعي في الهندسة الكيميائية) في KFUPM. الشيفرة الكاملة والسجلات ومشغِّل التجارب متاحة على GitHub.
الإعداد
- البيانات: STL-10، وفيها 100,000 صورة غير معنونة للتدريب المسبق الذاتي الإشراف، و5,000 صورة معنونة للضبط الدقيق (fine-tuning) والتقطير (distillation)، و8,000 صورة اختبار.
- المعلّمون: أربعة نماذج ResNet-18: ثلاثة دُرِّبت مسبقًا باستخدام SimCLR وBYOL وDINO ثم ضُبطت ضبطًا دقيقًا؛ وواحد دُرِّب تدريبًا خاضعًا للإشراف (supervised) من الصفر ليكون خط أساس.
- الطالب: MobileNetV3-Small، قُطِّر باستخدام:
- معلّم واحد،
- تجميع (ensemble) من معلّمَين أو ثلاثة،
- تقطير تدريجي، يتعلم فيه الطالب من معلّم بعد آخر.
- المشغِّل: سكربت واحد يشغّل التجارب الخمس والعشرين (25) كلها، ثم يقيس حجم النموذج وFLOPs ويبني الرسوم البيانية وجدول الملخص.
النتائج
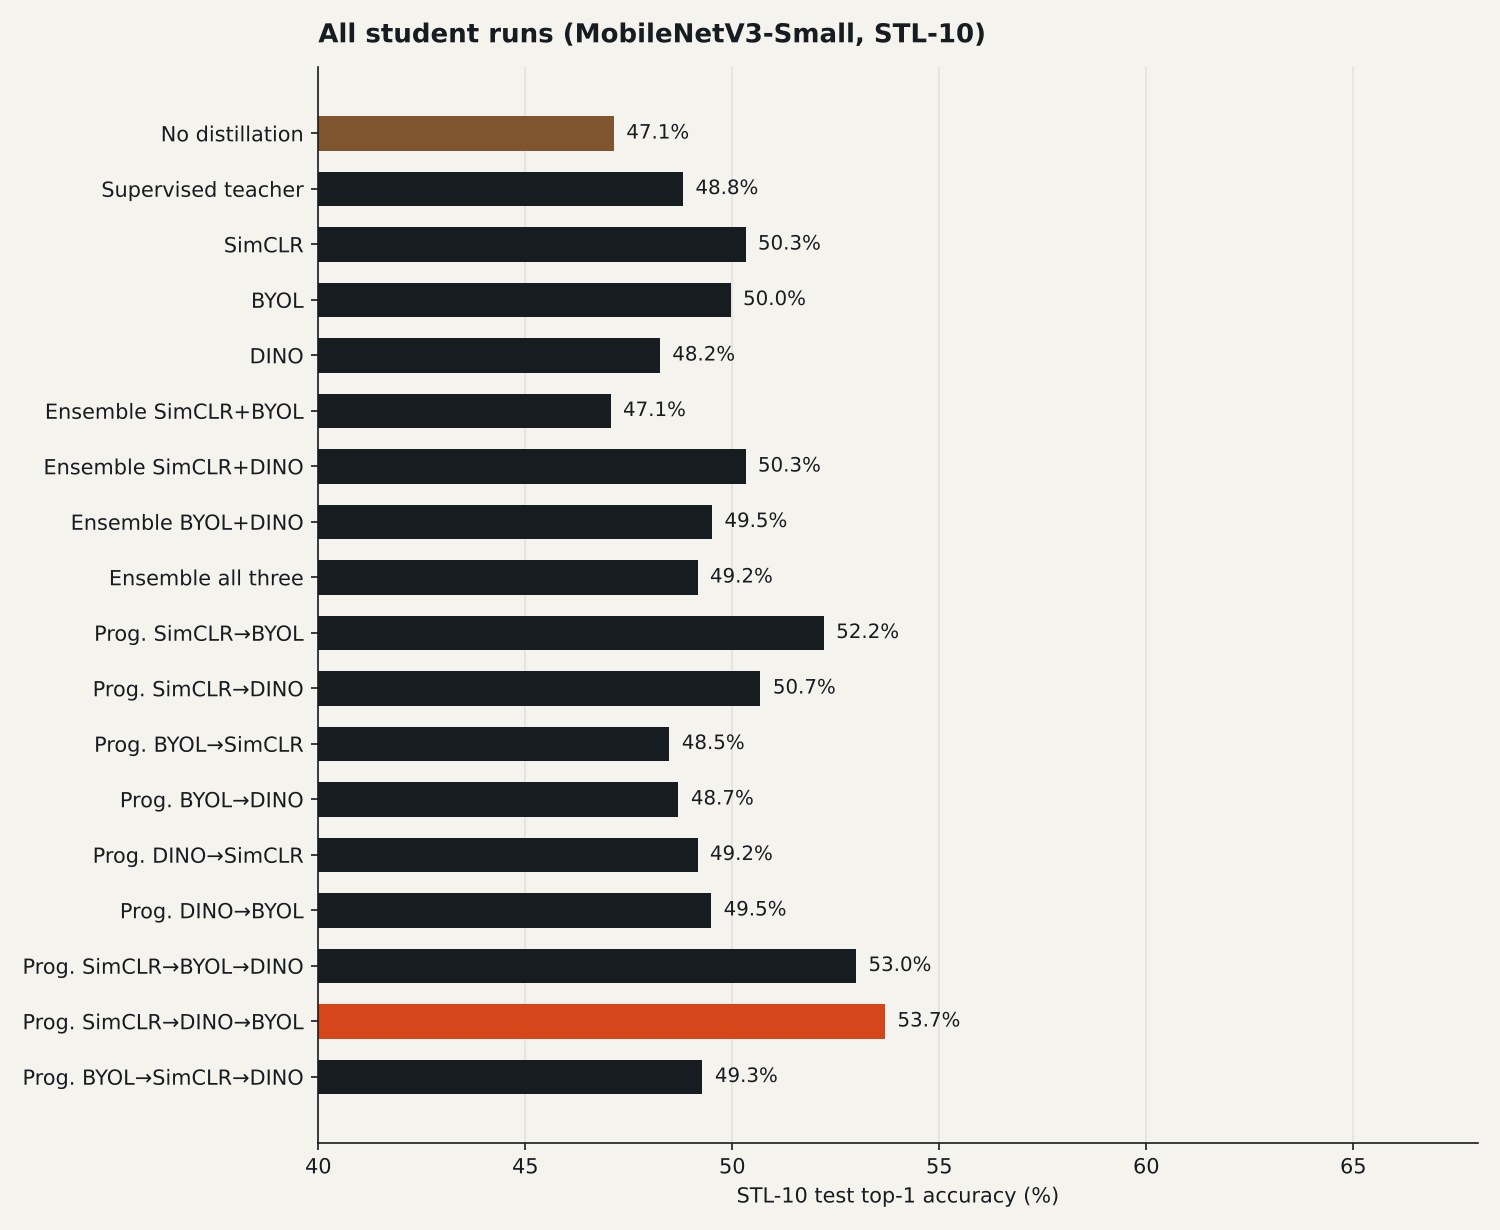
- الطالب المدرَّب منفردًا بلغ دقة top-1 مقدارها 47.1%.
- أفضل طالب مقطَّر (تدريجي، SimCLR → DINO → BYOL) بلغ 53.7%، أي بزيادة 6.6 نقطة.
- تراوحت دقة المعلّمين بين 57.9% (BYOL) و64.4% (الخاضع للإشراف).
ما الذي تقوله الأرقام فعلًا
- التقطير أفاد. كل الطلاب التدريجيين ومعظم طلاب التجميع تفوّقوا على الطالب المدرَّب منفردًا.
- المعلّمون بالتعلم الذاتي الإشراف لم يتفوّقوا هنا على المعلّم الخاضع للإشراف. مع 5,000 عنوان فقط وتدريب مسبق قصير، كان ResNet-18 الخاضع للإشراف أقوى المعلّمين. ميزانيات تدريب مسبق أفضل ستغيّر ذلك على الأرجح، لكن هذه الدراسة لا تُظهره.
- الطلاب التدريجيون تدرّبوا أيضًا مدة أطول. كل مرحلة إضافية أضافت 30 دورة تدريب (epoch)، ولذلك قد يعود جزء من تفوّقهم إلى التدريب الإضافي، لا إلى ترتيب المعلّمين وحده. المتابعة المنصفة تكون بمساواة العدد الكلي لدورات التدريب.
- الفجوة مع المعلّمين تبقى كبيرة (نحو 10 نقاط)، وهذا متوقع لطالب بهذا الصغر عند هذا الحجم من البيانات.